
881 lines
40 KiB
Markdown
881 lines
40 KiB
Markdown
---
|
|
source_url: "https://techblog.goinc.jp/entry/2022/06/14/090000"
|
|
ingested: 2026-07-02
|
|
sha256: c0be9eddbfa6f4a21a7a1354fe2d8fb67a8eba9e876e302c9b001c219bdcc726
|
|
discovered_from:
|
|
platform: discord
|
|
channel_id: "1028287639918497822"
|
|
channel_name: "chat"
|
|
message_id: "1522115794123882508"
|
|
author_id: "890908900520505354"
|
|
posted_at: "2026-07-02T05:44:44.863000000Z"
|
|
message_excerpt: "https://techblog.goinc.jp/entry/2022/06/14/090000"
|
|
---
|
|
タクシーアプリ「GO」、法人向けサービス「GO BUSINESS」、タクシーデリバリーアプリ「GO Dine」の分析基盤を開発運用している [伊田](https://d.hatena.ne.jp/keyword/%B0%CB%C5%C4) です。今回、dbt と Dataform を比較して Dataform を利用することにしましたので、導入経緯および Dataform の初期構築を紹介します。
|
|
|
|
※ 本記事の対象読者は [ELT](https://d.hatena.ne.jp/keyword/ELT) ツールを利用している方を対象にしています
|
|
|
|
これは [MoT Engineer Challenge Week 2022 Spring](https://lab.mo-t.com/blog/why-engineer-challenge-week) の記事です。
|
|
|
|
## はじめに
|
|
|
|
本記事では、まず、dbt および Dataform というツールについて簡単に説明させて頂き、次に現在データ分析チームが抱えている課題について取り上げます。その後、2つのツールについて検証した内容を紹介し、その結果、Dataform の導入に至った経緯を説明します。また、最後に Dataform の初期構築で工夫した点についても紹介させて頂きます。
|
|
|
|
ツール導入に至るまでに様々な記事を参考にさせて頂きました。最初に謝辞を述べさせて頂きますとともに、参考にしたサイトは本記事の最後に一覧として記載させて頂いています。
|
|
|
|
※ 検証および初期構築は千田と [伊田](https://d.hatena.ne.jp/keyword/%B0%CB%C5%C4) で実施しました
|
|
|
|
※ 検証は Engineer Challenge Week を利用して実施しました
|
|
|
|
## dbt / Dataform とは
|
|
|
|
dbt, Dataform という2つの製品は、 [ELT](https://d.hatena.ne.jp/keyword/ELT) のうち、Transform をするためのツールです。つまり、分析基盤にデータが格納された後に、 [SQL](https://d.hatena.ne.jp/keyword/SQL) を発行してデータの加工処理をするためのツールで、加えて null チェックや unique チェックなどのテスト、 [ドキュメンテーション](https://d.hatena.ne.jp/keyword/%A5%C9%A5%AD%A5%E5%A5%E1%A5%F3%A5%C6%A1%BC%A5%B7%A5%E7%A5%F3) 、データリネージ、データパイプラインの実行・スケジューリング等の管理もすることができます。
|
|
|
|
## dbt
|
|
|
|
- [公式サイト](https://www.getdbt.com/)
|
|
- [SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版と [CLI](https://d.hatena.ne.jp/keyword/CLI) 版([OSS](https://d.hatena.ne.jp/keyword/OSS))があります
|
|
- [SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版は3つのプランがあります
|
|
- Free: 個人の検証目的の場合は無料で使えます
|
|
- Team: チームで開発する場合は1人あたり $50 / Month 掛かります
|
|
- Enterprise: SSO や Custom SLAs など、より高度な機能が提供されます
|
|
|
|
## Dataform
|
|
|
|
- [SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版と [CLI](https://d.hatena.ne.jp/keyword/CLI) 版([OSS](https://d.hatena.ne.jp/keyword/OSS))があります
|
|
- 2020年に [Google](https://d.hatena.ne.jp/keyword/Google) に買収された結果、現在は無料で利用できます
|
|
- 利用は順番待ちとなっているため、 [こちら](https://docs.google.com/forms/d/e/1FAIpQLSdcm3v9fMU_-xmBcZi5klgeMYxr54l1_Ac3UABfJ0ogQfwQDQ/viewform) から申請する必要があります
|
|
|
|
## 前提
|
|
|
|
- 弊社の分析基盤は [GCP](https://d.hatena.ne.jp/keyword/GCP) BigQuery です。よって、以降の検証は BigQuery に関してのものです
|
|
- BIツールは Looker を利用しています
|
|
- 以前から Cloud Composer (Airflow) を利用したワークフローが稼働しています
|
|
- データエンジニア、データアーキテクトとの人数対比で、データアナリストは約5倍程度在籍しています
|
|
|
|
## 課題
|
|
|
|
現在、分析チームには、データマートのリリース速度や品質に課題があります。
|
|
|
|
1. データマートのリリース速度が遅い
|
|
1. データエンジニアの人数が少ない
|
|
2. エンジニアしかデータマートが作れない(Docker/Airflow の知識が必要)
|
|
2. 品質が悪い
|
|
1. テストをする仕組みがない(そこまで手が回っていない)
|
|
|
|
結果として、下記の事象が発生しています。
|
|
|
|
1. 新規依頼から構築完了までに時間が掛かるので、アナリストが簡単に構築できる BigQuery スケジューリングクエリでデータマートを生成している
|
|
1. 依存関係が定義できないので、巨大な [SQL](https://d.hatena.ne.jp/keyword/SQL) ができやすい
|
|
2. Looker にデータマート代わりの [ビジネスロジック](https://d.hatena.ne.jp/keyword/%A5%D3%A5%B8%A5%CD%A5%B9%A5%ED%A5%B8%A5%C3%A5%AF) が入っている
|
|
1. [ダッシュ](https://d.hatena.ne.jp/keyword/%A5%C0%A5%C3%A5%B7%A5%E5) ボードの描画が遅く、Slack 配信時に負荷が掛かり失敗しやすい
|
|
2. Looker の外側で、その [ビジネスロジック](https://d.hatena.ne.jp/keyword/%A5%D3%A5%B8%A5%CD%A5%B9%A5%ED%A5%B8%A5%C3%A5%AF) が使えない
|
|
3. 上流のデータが変わった時に気づけない(欠損やデータの期待値が違うなど)
|
|
1. 利用者側からのアラートがあがって初めて気づくこともある
|
|
|
|
こうした課題への対応として諸々機能がそろっている dbt や Dataform の検討をしました
|
|
|
|
1. データマートのリリース速度の改善
|
|
1. 今すぐデータエンジニアやデータアーキテクトの人数を増やすことは難しいため、データアナリストでもデータマートが作れる状態にしたい
|
|
2. データアナリストが触りやすい [GUI](https://d.hatena.ne.jp/keyword/GUI) ツールを導入することが望ましい
|
|
2. 品質の改善
|
|
1. モニタリングをするために、テスト機能が必要になる
|
|
2. テストをするために、テストがしやすい形に [SQL](https://d.hatena.ne.jp/keyword/SQL) を分割して書き直す必要がある
|
|
3. 分割した結果、中間View/Tableが増えるため、依存関係を考慮したスケジューラーが必要になる
|
|
|
|
## 検証
|
|
|
|
## 検証内容
|
|
|
|
- 普及度: 将来性や困った時に解決しやすいか
|
|
- 利用コスト: 予算確保および横展開のしやすさ
|
|
- 学習コスト: ツール利用の敷居の低さ
|
|
- 機能比較: 課題に対して必要な機能がそろっているか
|
|
- 運用: 運用のしやすさ
|
|
|
|
## 検証結果
|
|
|
|
### 普及度
|
|
|
|
[Google](https://d.hatena.ne.jp/keyword/Google) 検索による結果が下記です
|
|
|
|
- dbt: 約 18,700,000 件
|
|
- dataform: 約 320,000 件
|
|
|
|
※ 2022/3/31 確認
|
|
|
|
### 利用コスト
|
|
|
|
- dbt:
|
|
- 1人あたり $50 / Month 最大40人まで
|
|
- 加えて、参照権限のみのユーザーが50人分付与される
|
|
- それ以上は Enterprise に移行する必要があると思われる
|
|
- Dataform: 無料
|
|
|
|
### 学習コスト
|
|
|
|
主観的なものとなりますが、基本的には [SQL](https://d.hatena.ne.jp/keyword/SQL) + dbt / Dataform のお作法に則る形であるので、データアナリストが触る部分としては、dbt も Dataform もそこまで学習コストは高くないと感じました。
|
|
|
|
一部コア部分の作り込みや [CLI](https://d.hatena.ne.jp/keyword/CLI) 版については多少学習コストが必要だと思います。
|
|
|
|
### 機能比較
|
|
|
|
機能比較には、 [こちら](https://zenn.dev/dbt_tokyo/books/537de43829f3a0) の [チュートリアル](https://d.hatena.ne.jp/keyword/%A5%C1%A5%E5%A1%BC%A5%C8%A5%EA%A5%A2%A5%EB) を参考に行いました。
|
|
|
|
※ 主要なものを取り上げており、すべての機能を網羅しているわけではありません
|
|
|
|
**データモデル定義**
|
|
|
|
- dbt: [SQL](https://d.hatena.ne.jp/keyword/SQL) と [YAML](https://d.hatena.ne.jp/keyword/YAML) で構成される。 [YAML](https://d.hatena.ne.jp/keyword/YAML) にテスト、ドキュメントなどを記述する。Jinja やマクロを利用した柔軟な記述ができる。 [SQL](https://d.hatena.ne.jp/keyword/SQL) に config を設定することで、個々の [SQL](https://d.hatena.ne.jp/keyword/SQL) の挙動を制御できる
|
|
- Dataform: SQLX として、 [SQL](https://d.hatena.ne.jp/keyword/SQL) 、テスト、ドキュメントを1ファイルに記述する。 [JavaScript](https://d.hatena.ne.jp/keyword/JavaScript) を利用した柔軟な記述ができる。SQLX に config を設定することで、個々の [SQL](https://d.hatena.ne.jp/keyword/SQL) の挙動を制御できる
|
|
|
|
**前処理、後処理**
|
|
|
|
- dbt: pre-hook, post-hook を利用することで、クエリの前後に処理を挟むことができる
|
|
- Dataform: pre\_operations, post\_operations を利用することで、クエリの前後に処理を挟むことができる
|
|
|
|
**データロード**
|
|
|
|
- dbt: dbt プロジェクト内の [csv](https://d.hatena.ne.jp/keyword/csv) ファイルをロードする。型などは [csv](https://d.hatena.ne.jp/keyword/csv) ファイルから dbt が自動的に補完してくれる
|
|
- Dataform: 該当機能なし
|
|
|
|
**ソース定義**
|
|
|
|
- dbt:
|
|
- dbt の外側で作成されたテーブルについて、source を宣言することで SELECT文の中で参照できるようになる。SELECT文でテーブル名をベタ書きせずに、 `{{ source('table_name') }}` とするとデータリネージで表示されるようになる
|
|
- `dbt source freshness` コマンドでデータの鮮度チェックができる
|
|
- Dataform:
|
|
- Dataform の外側で作成されたテーブルについて、declaration を宣言することで SELECT文の中で参照できるようになる。SELECT文でテーブル名をベタ書きせずに、 `{{ ref('table_name') }}` とするとデータリネージで表示されるようになる
|
|
|
|
**クエリの部品化**
|
|
|
|
- dbt: ephemeral という機能を利用することで、 [SQL](https://d.hatena.ne.jp/keyword/SQL) を部品化できる。さらに、Jinja や macro を利用して柔軟な書き方ができる
|
|
- Dataform: [JavaScript](https://d.hatena.ne.jp/keyword/JavaScript) を利用して、 [SQL](https://d.hatena.ne.jp/keyword/SQL) を部品化できる
|
|
|
|
**Viewの作成**
|
|
|
|
- dbt: View を作成する。 `create or replace view` が実行される
|
|
- Dataform: View を作成する。 `create or replace view` が実行される
|
|
|
|
**Tableの作成**
|
|
|
|
- dbt: Table を作成する。 `create or replace table` が実行される
|
|
- Dataform: Table を作成する。 `create or replace table` が実行される
|
|
|
|
**Tableの作成 incremental model**
|
|
|
|
- dbt:
|
|
- Merge 文を実行することで増分・差分処理を実現する
|
|
- 初回実行時および、 `--full-refresh` オプションをつけると `create or replace table` が実行される
|
|
|
|
unique\_key の指定がない場合は Insert 処理
|
|
|
|
```sql
|
|
merge into dest
|
|
using (
|
|
select
|
|
.
|
|
.
|
|
.
|
|
from source
|
|
where
|
|
created_at > (select max(created_at) from dest)
|
|
) as source
|
|
on False
|
|
|
|
when not matched then insert
|
|
.
|
|
.
|
|
.
|
|
```
|
|
|
|
unique\_key の指定がある場合は Upsert 処理
|
|
|
|
```sql
|
|
merge into dest
|
|
using (
|
|
select
|
|
.
|
|
.
|
|
.
|
|
from source
|
|
where
|
|
created_at > (select max(created_at) from dest)
|
|
) as source
|
|
on dest.id = source.id
|
|
|
|
when matched then update set
|
|
.
|
|
.
|
|
.
|
|
when not matched then insert
|
|
.
|
|
.
|
|
.
|
|
```
|
|
|
|
incremental\_strategy で insert\_overwrite を指定した場合は DELETE INSERT による [パーティション](https://d.hatena.ne.jp/keyword/%A5%D1%A1%BC%A5%C6%A5%A3%A5%B7%A5%E7%A5%F3) 置換処理
|
|
|
|
```sql
|
|
-- 定義ファイル
|
|
-- 当日と前日分を取得する。柔軟にやる場合は macro を使う
|
|
{% set partitions_to_replace = [
|
|
'date(current_date)',
|
|
'date(date_sub(current_date, interval 1 day))'
|
|
] %}
|
|
|
|
{{
|
|
config(
|
|
materialized='incremental',
|
|
incremental_strategy = 'insert_overwrite',
|
|
unique_key='order_id',
|
|
partition_by={
|
|
'field': 'order_date',
|
|
'data_type': 'date'
|
|
},
|
|
partitions = partitions_to_replace
|
|
)
|
|
}}
|
|
|
|
select
|
|
id as order_id,
|
|
user_id as customer_id,
|
|
order_date,
|
|
status
|
|
from research_dbt.raw_orders
|
|
{% if is_incremental() %}
|
|
where order_date in ({{ partitions_to_replace | join(',') }})
|
|
{% endif %}
|
|
```
|
|
```sql
|
|
merge into \`myproject\`.\`research_dbt\`.\`stg_orders\` as DBT_INTERNAL_DEST
|
|
using (
|
|
select
|
|
id as order_id,
|
|
user_id as customer_id,
|
|
order_date,
|
|
status
|
|
from research_dbt.raw_orders
|
|
where order_date in (date(current_date),date(date_sub(current_date, interval 1 day)))
|
|
) as DBT_INTERNAL_SOURCE
|
|
on FALSE
|
|
|
|
when not matched by source
|
|
and DBT_INTERNAL_DEST.order_date in (
|
|
date(current_date), date(date_sub(current_date, interval 1 day))
|
|
)
|
|
then delete
|
|
when not matched then insert
|
|
(\`order_id\`, \`customer_id\`, \`order_date\`, \`status\`)
|
|
values
|
|
(\`order_id\`, \`customer_id\`, \`order_date\`, \`status\`)
|
|
```
|
|
- Dataform:
|
|
- Merge 文を実行することで増分・差分処理を実現する
|
|
- 初回実行時および、 `--full-refresh` オプションをつけると `create or replace table` が実行される
|
|
|
|
uniqueKey の指定がない場合は Insert 処理
|
|
|
|
```sql
|
|
insert into dest
|
|
select ... from source
|
|
where created_at > (select max(created_at) from dest)
|
|
```
|
|
|
|
unique\_key の指定がある場合は Upsert 処理
|
|
|
|
```sql
|
|
merge dest T
|
|
using (
|
|
select
|
|
.
|
|
.
|
|
.
|
|
from source
|
|
where created_at > (select max(created_at) from dest)
|
|
) S
|
|
on T.id = S.id
|
|
when matched then update set
|
|
.
|
|
.
|
|
.
|
|
when not matched then
|
|
.
|
|
.
|
|
.
|
|
```
|
|
|
|
updatePartitionFilter の指定がある場合は [パーティション](https://d.hatena.ne.jp/keyword/%A5%D1%A1%BC%A5%C6%A5%A3%A5%B7%A5%E7%A5%F3) のプルーニングが行われる
|
|
|
|
```sql
|
|
-- 定義ファイル
|
|
-- 前日分以降を更新対象にする。柔軟にやる場合は pre_operations を使う
|
|
config {
|
|
type: "incremental",
|
|
uniqueKey: ["order_id"],
|
|
bigquery: {
|
|
partitionBy: "order_date",
|
|
updatePartitionFilter: "order_date > DATE(TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 1 DAY))"
|
|
}
|
|
}
|
|
|
|
select
|
|
id as order_id,
|
|
user_id as customer_id,
|
|
order_date,
|
|
status
|
|
from ${ref("raw_orders")}
|
|
where
|
|
order_date > DATE(TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 2 DAY))
|
|
```
|
|
```sql
|
|
merge \`myproject.research_dataform.stg_orders\` T
|
|
using (
|
|
|
|
select
|
|
id as order_id,
|
|
user_id as customer_id,
|
|
order_date,
|
|
status
|
|
from \`myproject.research_dbt.raw_orders\`
|
|
where
|
|
order_date > DATE(TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 2 DAY))
|
|
) S
|
|
on T.order_id = S.order_id
|
|
and T.order_date > DATE(TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 2 DAY))
|
|
when matched then
|
|
update set \`order_id\` = S.order_id,\`customer_id\` = S.customer_id,\`order_date\` = S.order_date,\`status\` = S.status
|
|
when not matched then
|
|
insert (\`order_id\`,\`customer_id\`,\`order_date\`,\`status\`) values (\`order_id\`,\`customer_id\`,\`order_date\`,\`status\`)
|
|
```
|
|
|
|
**テスト**
|
|
|
|
- dbt:
|
|
- `unique`: `column_name` がユニークな値になっているか
|
|
- `not_null`: `column_name` が `null` を含んでいないか
|
|
- `accepted_values`: `column_name` が決められた値になっているか
|
|
- `relationships`: テーブルのキーがテスト対象のテーブルのキーと結合できるか
|
|
- 任意のテストを書きたい場合はマクロを書くか、 dbt\_utils にテスト用のマクロが用意されているので利用する
|
|
- Dataform:
|
|
- `uniqueKey`: `column_name` がユニークな値になっているか
|
|
- `nonNull`: `column_name` が `null` を含んでいないか
|
|
- `rowConditions`: 各行の条件が true になることを期待する [SQL](https://d.hatena.ne.jp/keyword/SQL) 式を記述する
|
|
- 任意の [アサーション](https://d.hatena.ne.jp/keyword/%A5%A2%A5%B5%A1%BC%A5%B7%A5%E7%A5%F3) を書きたい場合は `assertion` を宣言して、SELECT文の結果が0件となる [SQL](https://d.hatena.ne.jp/keyword/SQL) 式を記述する
|
|
|
|
**ドキュメント、データリネージ**
|
|
|
|
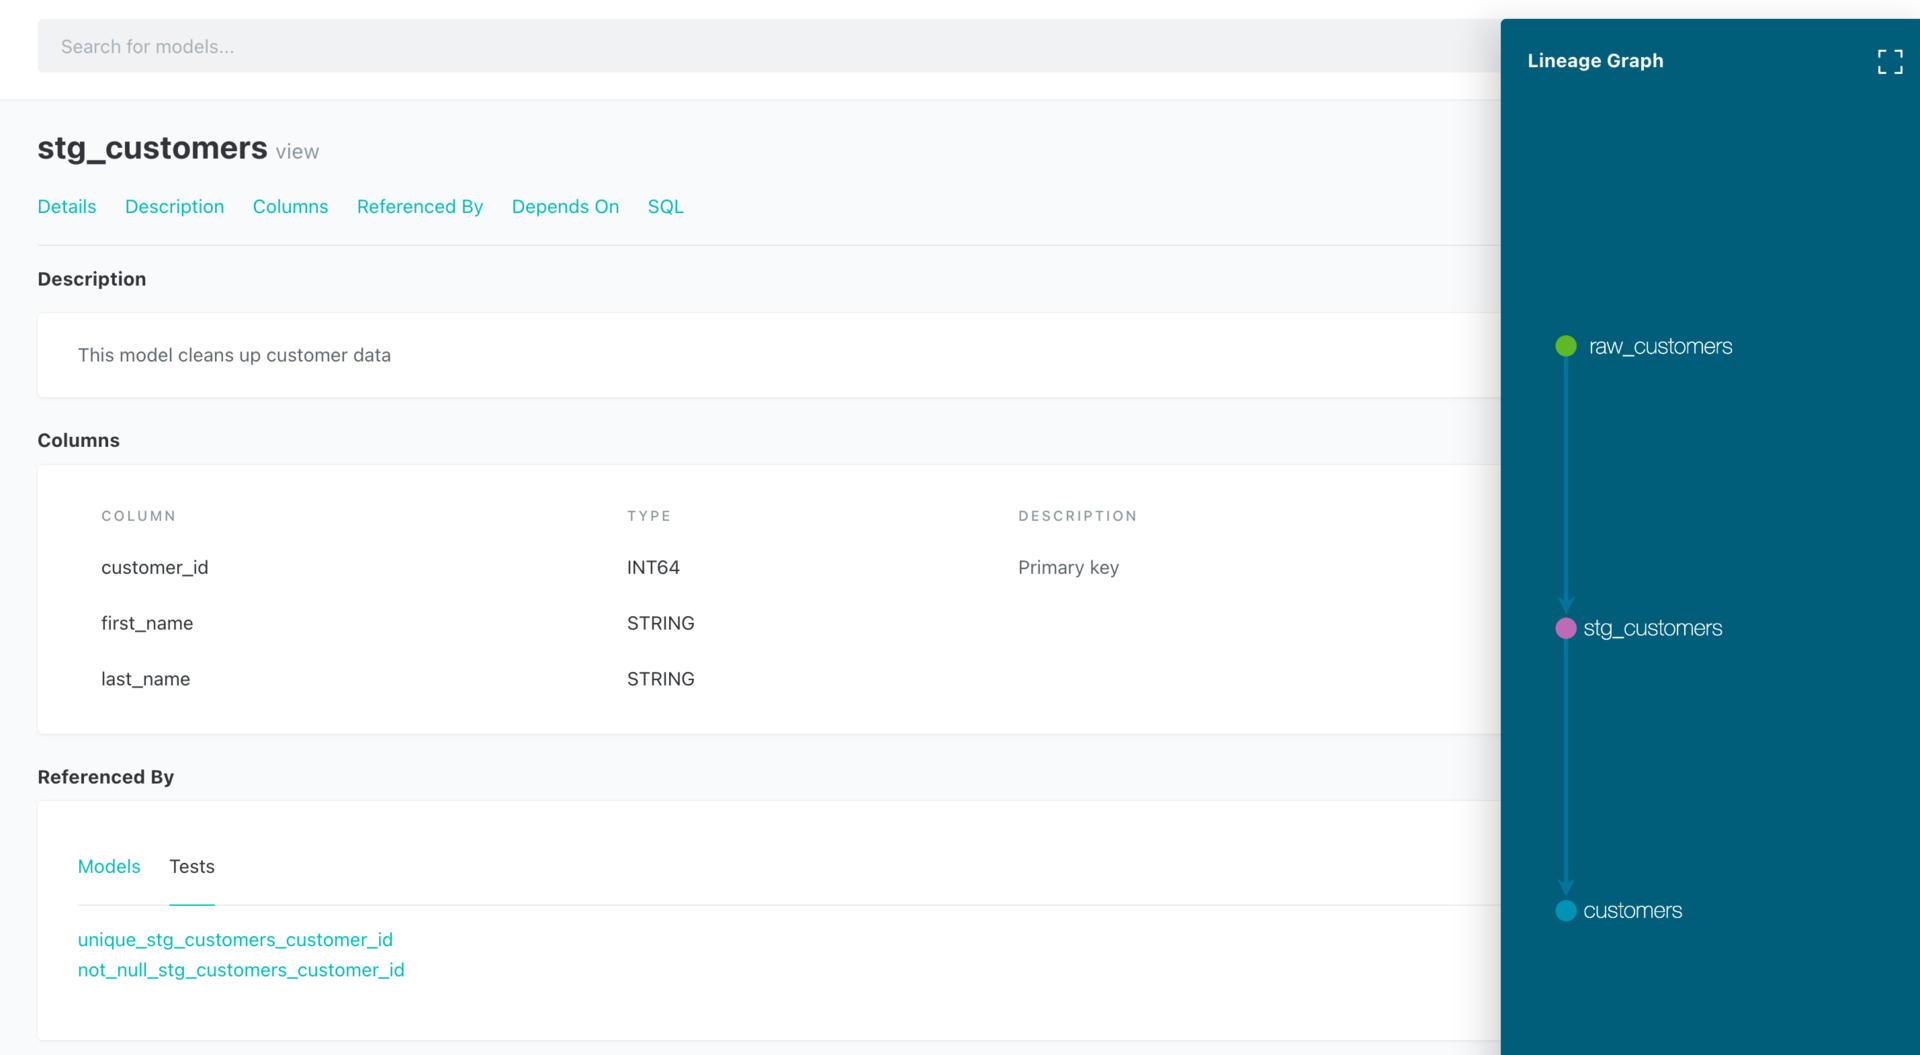
- dbt: テーブルのドキュメントを作成することができる
|
|
- [SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版、 [CLI](https://d.hatena.ne.jp/keyword/CLI) 版ともにドキュメント、データリネージが確認できる
|
|
- テーブルの Description
|
|
- 各カラムの Description
|
|
- テスト内容 (自動的に参照先が作られる)
|
|
- [SQL](https://d.hatena.ne.jp/keyword/SQL) に source / ref 関数を使用することで依存関係が定義され、データリネージが可視化できる
|
|
|
|
|
|
|
|
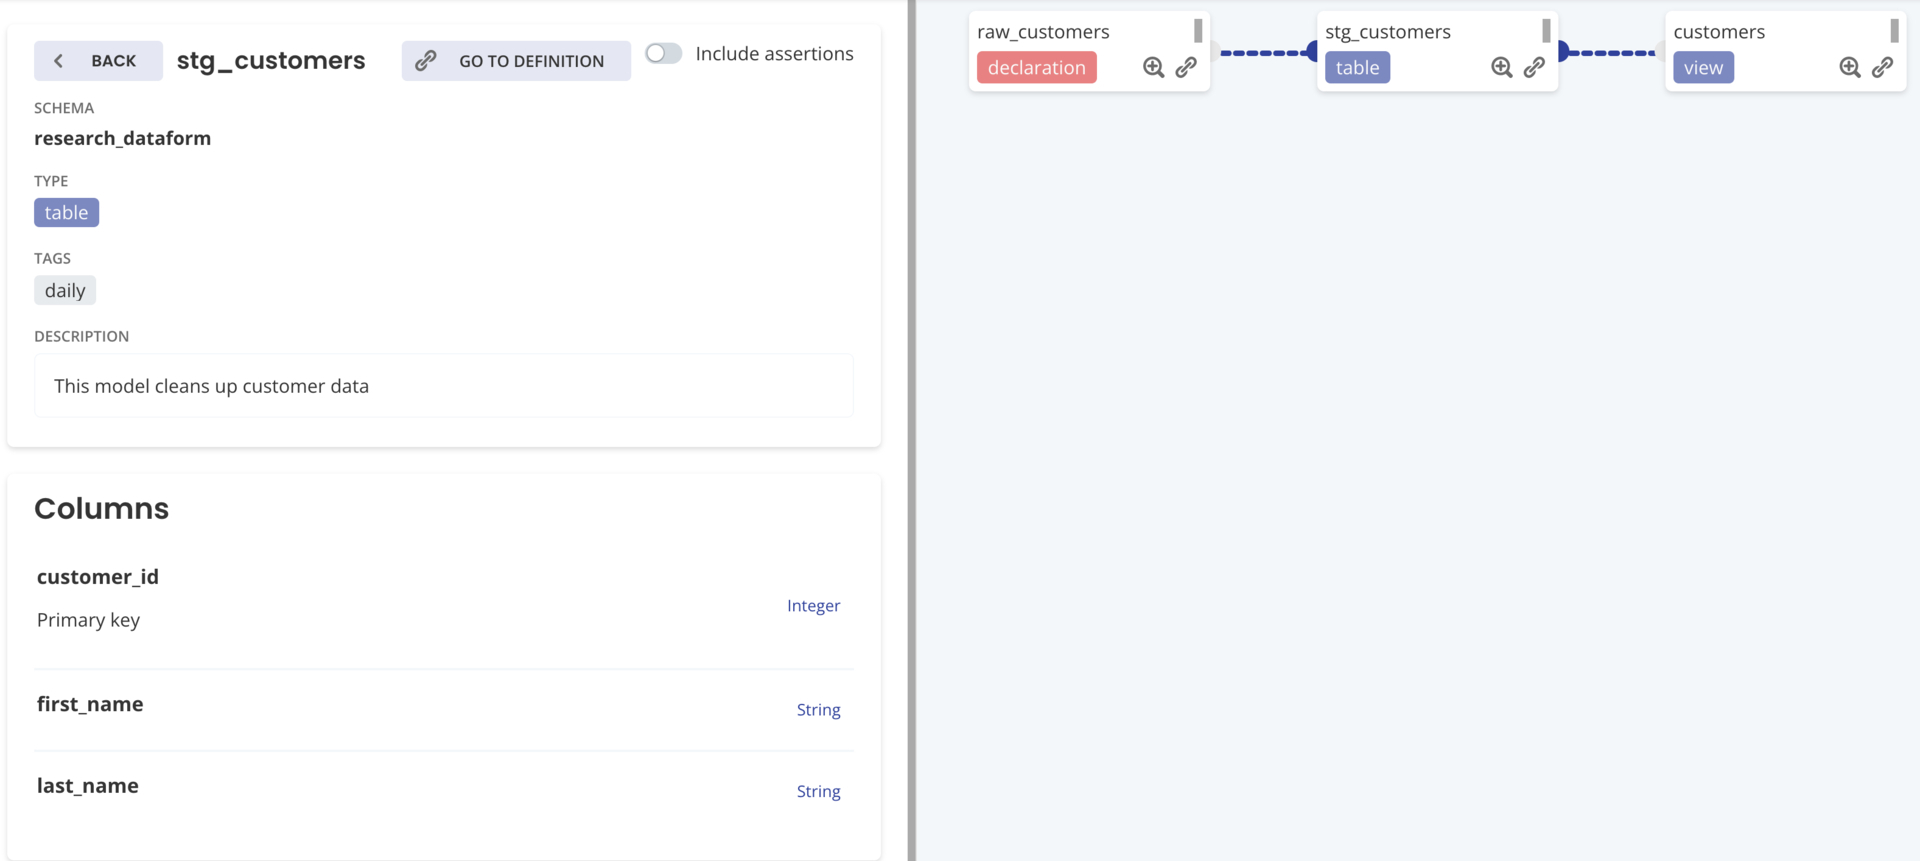
- Dataform: テーブルのドキュメントを作成することができる
|
|
- [SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版のみドキュメント、データリネージが確認できる
|
|
- テーブルの Description
|
|
- 各カラムの Description
|
|
- テスト内容 (自動的に参照先が作られる)
|
|
- [SQL](https://d.hatena.ne.jp/keyword/SQL) に ref 関数を使用することで依存関係が定義され、データリネージが可視化できる
|
|
|
|
|
|
|
|
**スナップショット**
|
|
|
|
- dbt:
|
|
- 初回は全レコードのスナップショットを作成する
|
|
- 2回目以降は、strategy に従って対象レコードのみスナップショットを作成する
|
|
- strategy
|
|
- `strategy='timestamp'` の場合、unique\_key, timestamp 列 を参照して変更があればスナップショットを取得する
|
|
- `strategy='check_cols'` の場合、unique\_key をもとに、対象となるカラムに変更があればスナップショットを取得する
|
|
- 画像は id, user\_id, order\_date, status までが対象テーブルの [スキーマ](https://d.hatena.ne.jp/keyword/%A5%B9%A5%AD%A1%BC%A5%DE) で、以降は dbt が付与した情報
|
|
|
|

|
|
|
|
- Dataform:
|
|
- incremental model としてスナップショットを取得する
|
|
- updated\_at を参照して、SELECT句に CURRENT\_TIMESTAMP() を付与して [差分バックアップ](https://d.hatena.ne.jp/keyword/%BA%B9%CA%AC%A5%D0%A5%C3%A5%AF%A5%A2%A5%C3%A5%D7) を取っていくイメージ
|
|
|
|
**ジョブ実行**
|
|
|
|
- dbt: ref 関数を使用することで依存関係が定義され、ジョブ実行時に依存関係を考慮して順次実行してくれる。指定したタグに紐付いたモデルのみ実行等もできる
|
|
- Dataform: ref 関数を使用することで依存関係が定義され、ジョブ実行時に依存関係を考慮して順次実行してくれる。指定したタグに紐付いたモデルのみ実行等もできる
|
|
|
|
### 運用
|
|
|
|
**スケジューラー**
|
|
|
|
- dbt: [SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版のみ。指定したタグに紐付いたモデルのみ実行等もできる
|
|
- Dataform: [SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版のみ。指定したタグに紐付いたモデルのみ実行等もできる
|
|
|
|
**[リカバリ](https://d.hatena.ne.jp/keyword/%A5%EA%A5%AB%A5%D0%A5%EA) / backfill**
|
|
|
|
- dbt: [SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版、 [CLI](https://d.hatena.ne.jp/keyword/CLI) 版ともに変数を指定して実行できる
|
|
- Dataform: [SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版は変数を指定して実行できない。 [CLI](https://d.hatena.ne.jp/keyword/CLI) 版は変数を指定して実行できる
|
|
|
|
**Slack通知**
|
|
|
|
- dbt: [SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版はSlack通知の設定ができる
|
|
- Dataform: [SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版はSlack通知の設定ができる
|
|
|
|
## 導入判断
|
|
|
|
## 結論
|
|
|
|
結論としては、Dataform を選択することにしました。不確定要素が多い中では、Dataform のほうがスモールスタートしやすいと判断しました。
|
|
|
|
## 理由
|
|
|
|
- 課題に対しては dbt / Dataform ともにクリア
|
|
- アナリストが自由にデータマートを作るために [GUI](https://d.hatena.ne.jp/keyword/GUI) が必要である
|
|
- テスト機能が必要である
|
|
- 導入までのハードルは Dataform が低い
|
|
- アナリストを巻き込んだ枠組みがうまくいくか不確定であるため、そうした中で予算確保の調整やライセンス管理はやりたくないため、無料の Dataform の方が有利である
|
|
- Dataform は今後 [GCP](https://d.hatena.ne.jp/keyword/GCP) に統合されることからセキュリティ面で会社許諾を得やすい
|
|
- [Google](https://d.hatena.ne.jp/keyword/Google) の担当者の方から「現在、Dataform (SasS版)を利用するためにサービスアカウントキーの発行が必要になりますが、今後は IAM に統合されます」という情報を確認しています
|
|
|
|
## 今後の展望として
|
|
|
|
結果が出て機能が物足りない場合は、dbt への移行も検討したいと思います。基本的な思想は同じなので移行は難しくなく、実績があれば予算も取りやすいと考えています。
|
|
|
|
今回は Dataform を選択しましたが、dbt と Dataform、この2つは素晴らしい製品だと思います。特に気に入っているのは ref 関数です。この関数があることでデータリネージとして可視化ができ、調査時に依存関係を簡単に把握することができます。また、ジョブ実行時も依存関係を考慮して自動的に順次実行してくれるのが嬉しいと感じています。
|
|
|
|
## 初期構築
|
|
|
|
ここからは Dataform 導入にあたり初期構築をどのようにしたか紹介したいと思います。
|
|
|
|
※ ここからは [チュートリアル](https://d.hatena.ne.jp/keyword/%A5%C1%A5%E5%A1%BC%A5%C8%A5%EA%A5%A2%A5%EB) 程度の知識がある前提で記述しています
|
|
|
|
## SaaS版とCLI版の併用
|
|
|
|
下記の理由から [SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版と [CLI](https://d.hatena.ne.jp/keyword/CLI) 版を併用することにしました。
|
|
|
|
- データアナリスト:スケジューリングクエリや Looker に組み込まれているロジックを Dataform 側に寄せる。スケジューラーの機能もあることからデータアナリストは [SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版で完結することができる
|
|
- データエンジニア、データアーキテクト:元々データ連携処理であったり、データマートの生成を Airflow 上で実行していることから、Dataform の処理を Airflow で設定した日付注入して実行したい。 [リカバリ](https://d.hatena.ne.jp/keyword/%A5%EA%A5%AB%A5%D0%A5%EA) や backfill の時に変数指定ができる [CLI](https://d.hatena.ne.jp/keyword/CLI) 版を使いたい
|
|
|
|
運用の流れとしては下記を想定しています。
|
|
|
|
1. データアナリストがデータアーキテクトのサポートの元、 [SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版でデータマートを作成する
|
|
2. 単発の場合は [SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版で完結し、本格運用に乗る場合はデータエンジニアに運用を引き継いてAirflow から実行できるように整備する
|
|
|
|
## GitHub連携
|
|
|
|
コードは [GitHub](https://d.hatena.ne.jp/keyword/GitHub) と連携しています。
|
|
|
|
## 環境
|
|
|
|
本番環境と開発環境は、 [GCP](https://d.hatena.ne.jp/keyword/GCP) プロジェクトでわけています(デー [タセット](https://d.hatena.ne.jp/keyword/%A5%BF%A5%BB%A5%C3%A5%C8) 配下は同じ構成)。
|
|
|
|
- 本番: prod-project
|
|
- 開発: dev-project
|
|
|
|
## environments.json
|
|
|
|
デフォルトは開発環境に向くようにして、master にマージされて初めて本番環境に処理が向くようにしています。
|
|
|
|
```sql
|
|
{
|
|
"environments": [
|
|
{
|
|
"name": "development",
|
|
"configOverride": {},
|
|
"gitRef": "develop"
|
|
},
|
|
{
|
|
"name": "production",
|
|
"configOverride": {
|
|
"defaultDatabase": "prod-project"
|
|
},
|
|
"gitRef": "master"
|
|
}
|
|
]
|
|
}
|
|
```
|
|
|
|
## ディレクトリ構成
|
|
|
|
definitions 配下([SQL](https://d.hatena.ne.jp/keyword/SQL) 置き場)はベストプ [ラク](https://d.hatena.ne.jp/keyword/%A5%E9%A5%AF) ティスに則って [ディレクト](https://d.hatena.ne.jp/keyword/%A5%C7%A5%A3%A5%EC%A5%AF%A5%C8) リを切りました。
|
|
|
|
- reporting: データマート層
|
|
- staging: データウェアハウス層
|
|
- sources: データレイク層
|
|
- playground: Dataform の機能テスト用
|
|
|
|
また、 [SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版で生成された初期ファイルに加えて、 [CLI](https://d.hatena.ne.jp/keyword/CLI) 版の利用や各種 [スクリプト](https://d.hatena.ne.jp/keyword/%A5%B9%A5%AF%A5%EA%A5%D7%A5%C8) を tools 配下に切っています。
|
|
|
|
```sql
|
|
.
|
|
├── definitions
|
|
│ ├── playground
|
|
│ ├── reporting
|
|
│ ├── sources
|
|
│ └── staging
|
|
├── includes
|
|
│ └── date_config.js
|
|
├── dataform.json
|
|
├── dataform_prod.json
|
|
├── environments.json
|
|
├── package-lock.json
|
|
├── package.json
|
|
└── tools
|
|
├── cli
|
|
└── scripts
|
|
```
|
|
|
|
## ファイルの命名
|
|
|
|
テーブル名.sqlx としています。
|
|
|
|
例えば、データマートにテーブルを作る場合は下記となります。
|
|
|
|
- definitions
|
|
- reporting
|
|
- dataset\_id
|
|
- table\_name.sqlx
|
|
|
|
## スキーマの指定、タグの指定
|
|
|
|
- Dataform では [スキーマ](https://d.hatena.ne.jp/keyword/%A5%B9%A5%AD%A1%BC%A5%DE) を省略して書くことができますが、BigQueryでは、別デー [タセット](https://d.hatena.ne.jp/keyword/%A5%BF%A5%BB%A5%C3%A5%C8) 同一テーブル名が存在する場合があるので、Dataform が解釈できるように [スキーマ](https://d.hatena.ne.jp/keyword/%A5%B9%A5%AD%A1%BC%A5%DE) を必ず指定します。 [スキーマ](https://d.hatena.ne.jp/keyword/%A5%B9%A5%AD%A1%BC%A5%DE) の指定は config と ref 関数で指定します。
|
|
- データパイプラインをスケジューリングして動かすために、一緒に処理が動く単位で同一のタグ付けをします ([SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版で動かす場合でも、Airflow で動かす場合でもタグ付けします)。
|
|
|
|
**dataset\_id.table\_name の場合**
|
|
|
|
```sql
|
|
config {
|
|
type: "incremental",
|
|
tags: ["dataform_test_dag_v1"],
|
|
schema: "dataset_id",
|
|
uniqueKey: ["id"],
|
|
bigquery: {
|
|
partitionBy: "DATE(ts)",
|
|
updatePartitionFilter: "ts >= raw_start_ts"
|
|
}
|
|
}
|
|
|
|
SELECT
|
|
.
|
|
.
|
|
.
|
|
FROM ${ref("ref_dataset_id", "ref_table_name")}
|
|
```
|
|
|
|
## 動的な日付指定
|
|
|
|
[SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版、 [CLI](https://d.hatena.ne.jp/keyword/CLI) 版ともに動的な日付を指定できるような [JavaScript](https://d.hatena.ne.jp/keyword/JavaScript) を作成しました。
|
|
|
|
まず、dataform.[json](https://d.hatena.ne.jp/keyword/json) に下記の通り変数を定義しています。
|
|
|
|
- targetStartTs: 対象期間いつから
|
|
- targetEndTs: 対象期間いつまで
|
|
- shouldOverrideVars: この変数が true のときに、targetStartTs、targetEndTs の変数を使って上書きする
|
|
|
|
**dataform.[json](https://d.hatena.ne.jp/keyword/json)**
|
|
|
|
```sql
|
|
{
|
|
"warehouse": "bigquery",
|
|
"defaultSchema": "dataform",
|
|
"assertionSchema": "dataform_assertions",
|
|
"defaultDatabase": "dev-project",
|
|
"vars": {
|
|
"shouldOverrideVars": "false",
|
|
"targetStartTs": "2022-04-01 09:00:00+9",
|
|
"targetEndTs": "2022-04-01 10:00:00+9"
|
|
}
|
|
}
|
|
```
|
|
|
|
**includes/date\_config.js**
|
|
|
|
最終的に生成する日付は4つです。
|
|
|
|
- start\_ts: 対象期間いつから
|
|
- end\_ts: 対象期間いつまで
|
|
- raw\_start\_ts: start\_ts からマージンを取ったタイムスタンプ
|
|
- raw\_end\_ts: end\_ts からマージンを取ったタイムスタンプ
|
|
|
|
日付を4つ定義しているのは、処理対象のテーブルにはストリーミングインサートで取り込み時間 [パーティション](https://d.hatena.ne.jp/keyword/%A5%D1%A1%BC%A5%C6%A5%A3%A5%B7%A5%E7%A5%F3) 分割テーブルに挿入されたデータがあり、そのようなテーブルに対しては、\_PARTITIONTIME に raw\_start\_ts と raw\_end\_ts を使って一時フィルタリングを行い、最終的に created\_at のような実際に処理対象としたいタイムスタンプに start\_ts と end\_ts を使って絞り込むためです。
|
|
|
|
[SaaS](https://d.hatena.ne.jp/keyword/SaaS) 版で実行する時は `shouldOverrideVars` は必ず `false` です。
|
|
|
|
[CLI](https://d.hatena.ne.jp/keyword/CLI) 版で実行するときは、 `shouldOverrideVars` は `true` を指定して、 `targetStartTs` と `targetEndTs` に任意の期間を指定します。
|
|
|
|
**date\_config.js**
|
|
|
|
```jsx
|
|
function getStartTs(unit, start_ago) {
|
|
if (\`${dataform.projectConfig.vars.shouldOverrideVars}\` == "true") {
|
|
return \`TIMESTAMP('${dataform.projectConfig.vars.targetStartTs}')\`;
|
|
} else {
|
|
return \`TIMESTAMP_TRUNC(TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL ${start_ago} ${unit}), HOUR)\`;
|
|
}
|
|
}
|
|
|
|
function getEndTs(unit, end_ago) {
|
|
if (\`${dataform.projectConfig.vars.shouldOverrideVars}\` == "true") {
|
|
return \`TIMESTAMP('${dataform.projectConfig.vars.targetEndTs}')\`;
|
|
} else {
|
|
return \`TIMESTAMP_TRUNC(TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL ${end_ago} ${unit}), HOUR)\`;
|
|
}
|
|
}
|
|
|
|
function getRawStartTs(unit, start_ago, start_margin) {
|
|
return \`TIMESTAMP_SUB(${getStartTs(unit, start_ago)}, INTERVAL ${start_margin} ${unit})\`
|
|
}
|
|
|
|
function getRawEndTs(unit, end_ago, end_margin) {
|
|
return \`TIMESTAMP_ADD(${getEndTs(unit, end_ago)}, INTERVAL ${end_margin} ${unit})\`
|
|
}
|
|
|
|
/*
|
|
BigQuery Scripting
|
|
*/
|
|
function createTemporaryFunctionGetHourUnitTs(start_ago=1, end_ago=0, start_margin=0, end_margin=0) {
|
|
return \`"""
|
|
create temporary function getHourUnitTs(ts STRING) AS (
|
|
CASE ts
|
|
WHEN 'raw_start_ts' THEN ${getRawStartTs('HOUR', start_ago, start_margin)}
|
|
WHEN 'raw_end_ts' THEN ${getRawEndTs('HOUR', end_ago, end_margin)}
|
|
WHEN 'start_ts' THEN ${getStartTs('HOUR', start_ago)}
|
|
WHEN 'end_ts' THEN ${getEndTs('HOUR', end_ago)}
|
|
END
|
|
);
|
|
"""\`
|
|
}
|
|
|
|
function createTemporaryFunctionGetDayUnitTs(start_ago=1, end_ago=0, start_margin=0, end_margin=0) {
|
|
return \`"""
|
|
create temporary function getDayUnitTs(ts STRING) AS (
|
|
CASE ts
|
|
WHEN 'raw_start_ts' THEN ${getRawStartTs('DAY', start_ago, start_margin)}
|
|
WHEN 'raw_end_ts' THEN ${getRawEndTs('DAY', end_ago, end_margin)}
|
|
WHEN 'start_ts' THEN ${getStartTs('DAY', start_ago)}
|
|
WHEN 'end_ts' THEN ${getEndTs('DAY', end_ago)}
|
|
END
|
|
);
|
|
"""\`
|
|
}
|
|
|
|
module.exports = {
|
|
createTemporaryFunctionGetHourUnitTs,
|
|
createTemporaryFunctionGetDayUnitTs
|
|
};
|
|
```
|
|
|
|
使い方としては下記です。
|
|
|
|
**createTemporaryFunctionGetHourUnitTs**
|
|
|
|
**引数(=デフォルト値)**
|
|
|
|
- start\_ago=1
|
|
- `start_ts` がスケジュール実行時間の何時間前か
|
|
- end\_ago=0
|
|
- `end_ts` がスケジュール実行時間の何時間前か
|
|
- start\_margin=0
|
|
- `raw_start_ts` が `start_ts` の何時間前か
|
|
- end\_margin=0
|
|
- `raw_end_ts` が `end_ts` の何時間後か
|
|
|
|
pre\_operations 内で、EXECUTE IMMEDIATE FORMAT を実行することで、create temporary function を実行し、日付を取得できるようにしています。
|
|
|
|
```sql
|
|
-- createTemporaryFunctionGetHourUnitTs
|
|
pre_operations {
|
|
EXECUTE IMMEDIATE FORMAT(${date_config.createTemporaryFunctionGetHourUnitTs(
|
|
/* start_ago = */ 1,
|
|
/* end_ago = */ 0,
|
|
/* start_margin = */ 24,
|
|
/* end_margin = */ 24)});
|
|
}
|
|
|
|
SELECT
|
|
.
|
|
.
|
|
.
|
|
FROM $ref("dataset_id", "table_name")
|
|
WHERE
|
|
_PARTIONTIME >= getHourUnitTs('raw_start_ts')
|
|
AND _PARTIONTIME < getHourUnitTs('raw_end_ts')
|
|
AND created_at >= getHourUnitTs('start_ts')
|
|
AND created_at < getHourUnitTs('end_ts')
|
|
```
|
|
|
|
2022/5/2 10:10 ([JST](https://d.hatena.ne.jp/keyword/JST)) に実行した場合、
|
|
|
|
- start\_ts: 2022-05-02 00:00:00 [UTC](https://d.hatena.ne.jp/keyword/UTC)
|
|
- end\_ts: 2022-05-02 01:00:00 [UTC](https://d.hatena.ne.jp/keyword/UTC)
|
|
- raw\_start\_ts: 2022-05-01 00:00:00 [UTC](https://d.hatena.ne.jp/keyword/UTC)
|
|
- raw\_end\_ts: 2022-05-03 01:00:00 [UTC](https://d.hatena.ne.jp/keyword/UTC)
|
|
|
|
となります。
|
|
|
|
## その他ツール類
|
|
|
|
ここからは Dataform 導入にあたり整備したツール類を紹介します。
|
|
|
|
### Docker関連
|
|
|
|
tools/ [cli](https://d.hatena.ne.jp/keyword/cli) 配下は下記のようになっています。
|
|
|
|
```sql
|
|
tools/cli
|
|
├── Dockerfile
|
|
├── README.md
|
|
├── compiled
|
|
├── compiled_json_analyzer.js
|
|
├── deploy.sh
|
|
├── df-credentials.json
|
|
├── df-credentials_prod.json
|
|
├── docker-compose.yaml
|
|
├── docker-compose_prod.yaml
|
|
└── settings.json
|
|
```
|
|
|
|
2種類あるファイルは、本番環境と開発環境用で無印が開発環境用です。docker image は本番用と開発用で切り分けています。
|
|
|
|
**Dockerfile**
|
|
|
|
*env=”* prod” が渡されると本番用です。
|
|
|
|
```sql
|
|
FROM node:17-buster-slim
|
|
|
|
ARG _env=""
|
|
|
|
# 基本的に依存するものはないのでコンテナ内で使う可能性があるものを追記する
|
|
RUN apt-get update \
|
|
&& apt-get dist-upgrade -y \
|
|
&& apt-get install -y --no-install-recommends \
|
|
vim \
|
|
jq \
|
|
&& apt-get clean \
|
|
&& rm -rf \
|
|
/var/lib/apt/lists/* \
|
|
/tmp/* \
|
|
/var/tmp/*
|
|
|
|
WORKDIR /usr/app/dataform
|
|
|
|
RUN npm i -g @dataform/[email protected]
|
|
|
|
# dataform cli 使用時の設定
|
|
COPY tools/cli/settings.json /root/.dataform/
|
|
# OAuth 認証のため接続先のプロジェクトのみが記載されている
|
|
COPY tools/cli/df-credentials${_env}.json /usr/app/dataform/.df-credentials.json
|
|
|
|
# 資材
|
|
COPY definitions /usr/app/dataform/definitions
|
|
COPY includes /usr/app/dataform/includes
|
|
COPY dataform${_env}.json /usr/app/dataform/dataform.json
|
|
COPY package.json /usr/app/dataform/
|
|
|
|
RUN dataform install .
|
|
|
|
ENTRYPOINT tail -f /dev/null
|
|
```
|
|
|
|
**setting.[json](https://d.hatena.ne.jp/keyword/json)**
|
|
|
|
dataform init で生成されるファイルです。
|
|
|
|
```sql
|
|
{
|
|
"allowAnonymousAnalytics": true,
|
|
"anonymousUserId": "your-anonymous-user-id"
|
|
}
|
|
```
|
|
|
|
**df-credentials.[json](https://d.hatena.ne.jp/keyword/json)**
|
|
|
|
同じく、dataform init で生成されるファイルです。
|
|
|
|
```sql
|
|
{
|
|
"projectId": "dev-project",
|
|
"location": "US"
|
|
}
|
|
```
|
|
|
|
**docker-compose.[yaml](https://d.hatena.ne.jp/keyword/yaml)**
|
|
|
|
```sql
|
|
version: "3"
|
|
services:
|
|
dataform:
|
|
# image: your-image-path
|
|
build:
|
|
context: ../../
|
|
dockerfile: tools/cli/Dockerfile
|
|
args:
|
|
_env: ""
|
|
container_name: dev
|
|
volumes:
|
|
- ~/.config/gcloud:/root/.config/gcloud
|
|
- ../../definitions:/usr/app/dataform/definitions
|
|
- ../../includes:/usr/app/dataform/includes
|
|
# - ./compiled:/usr/app/dataform/compiled
|
|
# - ./compiled_json_analyzer.js:/usr/app/dataform/compiled_json_analyzer.js
|
|
```
|
|
|
|
この docker image を Airflow の GKEPodOperator で呼び出して Dataform を実行しています。
|
|
|
|
実行コマンドは下記です。
|
|
|
|
- actions を指定すると、対象のテーブルと対象テーブルの assertion が実行されます。
|
|
- vars を指定すると、変数を指定できます。この例では、対象期間いつから、いつまでを指定しています。
|
|
- Airflow から日付を取得して変数として注入し、かつ上述の date\_config.js と組み合わせることで任意の期間のデータを生成することができます。
|
|
```sql
|
|
dataform run \
|
|
--actions destination \
|
|
--vars=shouldOverrideVars=true,targetStartTs='YYYY-MM-DD hh:mi:ss+9',targetEndTs='YYYY-MM-DD hh:mi:ss+9'
|
|
```
|
|
|
|
### Airflow 用コード変換ツール
|
|
|
|
dbt の [こちら](https://www.astronomer.io/blog/airflow-dbt-1) の記事を参考に、Airflow の1タスク = Dataform の1テーブル生成処理としたかったのでツールを作りました。ただし、Airflow 上で DAG の解析に負荷を掛けることをしたくないため、Airflow 上で動的に作るのではなく、タスクの依存関係を考慮した Airflow 用のコードを出力するツールを用意しました。
|
|
|
|
dbt の manifest.[json](https://d.hatena.ne.jp/keyword/json) に相当するデータは下記のコマンドから出力できます。
|
|
|
|
```sql
|
|
dataform compile --json > manifest.json
|
|
```
|
|
|
|
### クエリ生成ツール
|
|
|
|
Dataform で [コンパイル](https://d.hatena.ne.jp/keyword/%A5%B3%A5%F3%A5%D1%A5%A4%A5%EB) されたクエリをファイルとして生成したくて compiled\_ [json](https://d.hatena.ne.jp/keyword/json) \_analyzer.js というツールを用意しました(dbt は [コンパイル](https://d.hatena.ne.jp/keyword/%A5%B3%A5%F3%A5%D1%A5%A4%A5%EB) 時にクエリが出力されます)。
|
|
|
|
docker コンテナ内で下記のコマンドを打つと、 [json](https://d.hatena.ne.jp/keyword/json) ファイルを解析して [SQL](https://d.hatena.ne.jp/keyword/SQL) ファイルに変換してくれます。
|
|
|
|
```sql
|
|
dataform compile --json | node compiled_json_analyzer.js
|
|
```
|
|
|
|
### declaration 用コード生成ツール
|
|
|
|
既存のテーブルを Dataform の declaration として取り込みたいので、BigQuery のデー [タセット](https://d.hatena.ne.jp/keyword/%A5%BF%A5%BB%A5%C3%A5%C8) を指定すると、デー [タセット](https://d.hatena.ne.jp/keyword/%A5%BF%A5%BB%A5%C3%A5%C8) 配下のテーブルを declaration ファイルとして出力するツールを用意しました。
|
|
|
|
## おわりに
|
|
|
|
本記事では、dbt と Dataform を比較検討し、Dataform の導入に至った背景を説明しました。また、Dataform の初期構築のア [イデア](https://d.hatena.ne.jp/keyword/%A5%A4%A5%C7%A5%A2) も紹介させて頂きました。
|
|
|
|
今後は Dataform を分析チーム内に浸透させ、当初の課題だったデータアナリストが気軽にデータパイプラインを作れない状況を減らし、野良スケジューリングクエリを Dataform に移行させることや、 [ビジネスロジック](https://d.hatena.ne.jp/keyword/%A5%D3%A5%B8%A5%CD%A5%B9%A5%ED%A5%B8%A5%C3%A5%AF) を Looker に作り込まないように是正をしていきたいと考えています。加えて、分析基盤のデータの品質向上に注力できる状態を作っていきたいと考えています。
|
|
|
|
この比較記事が皆様のご参考になれば幸いです。
|
|
|
|
## 参考
|
|
|
|
- [dbtとDataformを比較し、dbtを使うことにした](https://attsun1031.github.io/blog/dbt-dataform-comparison)
|
|
- [dbt Cloudで始めるデータパイプライン構築のdbt入門](https://zenn.dev/dbt_tokyo/books/537de43829f3a0)
|
|
- [Airflowの処理の一部をdbtに移行しようとして断念した話](https://tech.classi.jp/entry/2021/08/19/120000)
|
|
- [タイミーのデータ基盤品質。これまでとこれから。(問題3: ETLパイプラインにおける加工処理の負債)](https://tech.timee.co.jp/entry/2022/01/24/113000#%E5%95%8F%E9%A1%8C3-ETL%E3%83%91%E3%82%A4%E3%83%97%E3%83%A9%E3%82%A4%E3%83%B3%E3%81%AB%E3%81%8A%E3%81%91%E3%82%8B%E5%8A%A0%E5%B7%A5%E5%87%A6%E7%90%86%E3%81%AE%E8%B2%A0%E5%82%B5)
|
|
- [データエンジニア界隈で話題のdbt(data build tool)のまとめ](https://qiita.com/manabian/items/67af7e4476d436aded77)
|
|
- [dbtを触ってみた感想](https://www.yasuhisay.info/entry/2021/07/25/011000)
|
|
- [\[dbt\] 作成するデータモデルに関するドキュメントを生成する](https://dev.classmethod.jp/articles/dbt-documentation/)
|
|
- [Building a Scalable Analytics Architecture With Airflow and dbt](https://www.astronomer.io/blog/airflow-dbt-1)
|
|
- [Dataform を導入してみた話](https://cam-inc.co.jp/p/techblog/600507634579145665)
|
|
- [Data Engineering Study #13 - ELT・データモデリングツール特集回](https://www.youtube.com/watch?v=B0ZTFhczGjs)
|